AI 모델이 검색을 하는 방법
이번 블로그에서는 AI 모델이 검색을 하는 방법에 대한 글을 작성해 보겠습니다.
왜 AI는 스스로 검색을 못 하는지
AI 모델을 인터넷도 전화도 없는 방에 갇힌 똑똑한 사람이라고 생각하면 이해하기 쉽습니다.
이 사람은 학습할 때 읽은 책의 내용은 잘 알고 있지만, 학습 이후에 발생한 일인 오늘의 뉴스나 특정 웹페이지의 최신 정보는 알 수 없습니다. 무엇보다 방 밖으로 나갈 수도 없습니다.
그렇다면 최신 정보가 필요할 때 AI가 할 수 있는 방법은 무엇일까요?
바로 문 밑으로 쪽지를 밀어 넣는 것입니다. → "이거 좀 검색해 줘: 오늘 서울 날씨"
이 쪽지가 바로 AI가 외부 도구를 사용하기 위해 보내는 tool_use 블록(JSON)입니다.
누군가 이 쪽지를 받아 실제로 검색한 뒤, 그 결과를 다시 방 안으로 넣어준다면 AI는 그 정보를 읽고 답변을 작성할 수 있습니다. 즉, AI가 직접 인터넷을 돌아다니며 검색하는 것이 아니라, 필요한 경우 도구를 호출하고 그 결과를 전달받는 방식입니다.
이것이 바로 Tool Use / Function Calling의 기본적인 동작 원리입니다.
공통 동작 원리: Tool Use 라운드트립
어느 방식이든 기본 구조는 같습니다.
- 클라이언트 → 모델: 메시지 + 사용 가능한 tool 목록(JSON Schema) 전송
- 모델 → 클라이언트: 응답에 tool_use 블록 포함
{ "type": "tool_use", "name": "web_search", "input": { "query": "..." } }
- (누군가) 실제로 검색을 실행
- 실행 결과를 tool_result로 모델에게 다시 전달
- 모델이 결과를 읽고 최종 답변 생성
이때 (누군가) 실제로 검색을 실행에서가 바로 클라이언트 방식과 AI Gateway(서버 사이드) 방식을 가르는 지점입니다.
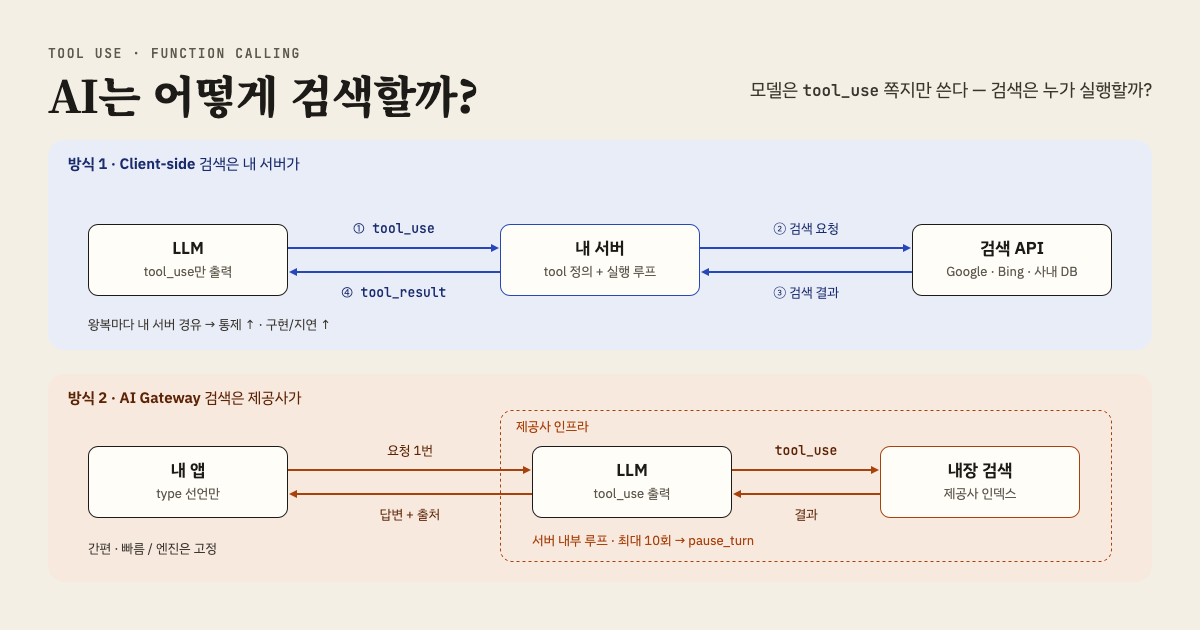
1. 클라이언트에서 실행하기 (Client-side Tool Execution)
동작 흐름
- 개발자가 web_search라는 커스텀 tool을 정의합니다. (이름, 설명, input schema)
- 모델은 검색이 필요하다고 판단하면 tool_use 블록만 반환하며 실제 검색은 절대 하지 않습니다.
- 내 애플리케이션 코드(백엔드)가 쿼리를 받아 Google / Bing / Serper API 등 실제 검색 엔진을 호출합니다.
- 검색 결과를 tool_result 메시지로 만들어 모델에게 돌려보냅니다.
- 모델이 결과를 바탕으로 답을 생성합니다.
Tool 정의 예시
{
  "name": "web_search",
  "description": "실시간 웹 검색이 필요할 때 호출",
  "input_schema": {
    "type": "object",
    "properties": {
      "query": { "type": "string" }
    },
    "required": ["query"]
  }
}
특징
- 검색 엔진, 결과 필터링, 캐싱, 도메인 제한 등을 개발자가 100% 통제하게 됩니다.
- 라운드트립마다 HTTP 요청이 왕복 → 지연 시간 및 토큰 비용이 발생하게 됩니다.
- 모델 → 내 서버 → 검색 API → 내 서버 → 모델
- 루프를 직접 짜거나(manual loop), SDK의 Tool Runner 같은 헬퍼로 자동화할 수 있습니다.
2. AI Gateway(서버 사이드)를 이용해서 실행하기 (Server-side Tool)
일부 모델 제공사(Anthropic, OpenAI 등)는 검색 기능이 내장된 tool을 제공합니다. 이 경우는 흐름이 다릅니다.
동작 흐름
- 개발자는 tool 스키마를 직접 정의할 필요 없이 타입만 선언합니다.
- 모델이 검색이 필요하다고 판단하면, 모델 제공사의 인프라에서 직접 검색을 실행하고 결과를 모델 컨텍스트에 넣어줍니다.
- 내부적으로 서버 사이드에서 자체 샘플링 루프(최대 반복 횟수, 기본 10회)를 돌리며, 필요하면 결과를 코드 실행으로 재필터링(dynamic filtering) 합니다.
- 반복 한도를 넘기면 응답의 stop_reason이 pause_turn으로 오게 됩니다.
- 같은 대화를 그대로 다시 보내면 게이트웨이가 이어서 처리하게 됩니다. ("계속해 줘" 같은 문구 추가 불필요)
Tool 선언 예시
{
  "tools": [
    { "type": "web_search_20260209", "name": "web_search" }
  ]
}
특징
- 검색 엔진 인프라를 직접 구축/운영할 필요 없습니다. (제공사가 자체 검색 인덱스/크롤러 사용)
- 결과가 web_search_tool_result 같은 전용 블록 타입으로 출처 URL, 스니펫 등과 함께 구조화되어 반환됩니다.
- allowed_domains / blocked_domains, max_uses, user_location 같은 옵션으로 검색 범위를 제한 가능합니다.
- 클라이언트-서버 왕복이 없어 지연 시간과 구현 복잡도가 낮습니다.
- 대신 커스텀 검색 엔진(사내 문서 검색 등)은 사용 불가합니다. → 이 경우엔 방식 1(client-side)로 가야 합니다.
참고 자료
https://malwareanalysis.tistory.com/955
AI 모델은 인터넷 검색은 못하는데, 어떻게 인터넷 검색을 할까?
AI 모델은 인터넷검색을 하지 못합니다. AI 모델은 정말 인터넷 검색을 못할까?LiteLLM을 Docker로 실행하고, Amazon Bedrock의 Nova 1.0과 Qwen2.5-1.5B-Instruct를 연결했습니다. LiteLLM Playground에서 오늘 날씨를
malwareanalysis.tistory.com
이것으로 AI 모델이 검색을 하는 방법에 대해 알아보는 글을 마치겠습니다. 감사합니다!